
NEWS
当前 AI 芯片的算力需求持续多元化,除专用 NPU 外,对高性能通用并行计算内核的需求日益凸显。为此,芯来科技正式推出首款支持 Vector Matrix Extension 的高性能 AI 通用处理器 IP——NI1000 RISC-V CPU IP。依托 RVV 向量、VME 矩阵扩展实现全域加速,为国产 AI 芯片提供一体化融合通用算力内核。
芯来NI系列CPU IP,赋能国产AI芯片
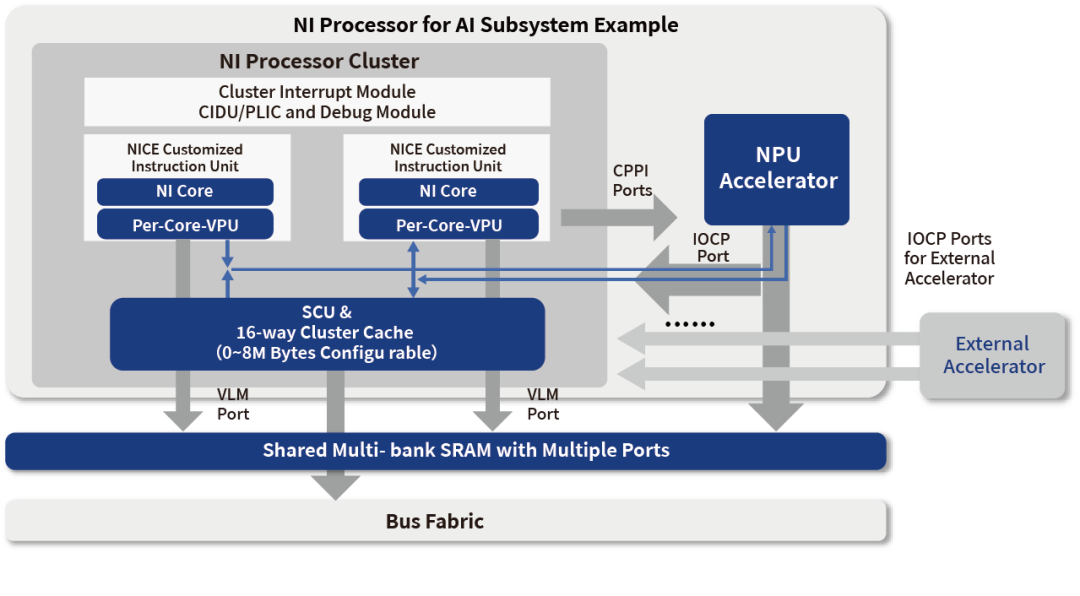
NI 系列是芯来科技针对人工智能应用的专用处理器产品线,支持配置为 900 系列或 1000 系列任意一款,RVV 1.0 VPU 的 VLEN 可配置为 512b /1024b /2048b /4096b,并支持 Cluster 内每个 Core 独立配置 VPU。通过 IOCP(IO Coherent Port)与 NPU 加速器紧耦合,保持缓存一致性,降低数据搬移开销。NICE/VNICE 接口支持用户自定义标量/向量指令,也可通过 NICE 接口与 NPU 进行紧耦合互动。
注意:
NI 系列 CPU IP 并非取代 NPU、GPU 等加速器 IP,而是与之进行结合,更好的服务 AI SoC 上的加速器,提供 AI 芯片公司更完善的整体解决方案。
芯来科技高性能 AI 通用处理器 IP —— NI1000
超宽 RVV 向量能力
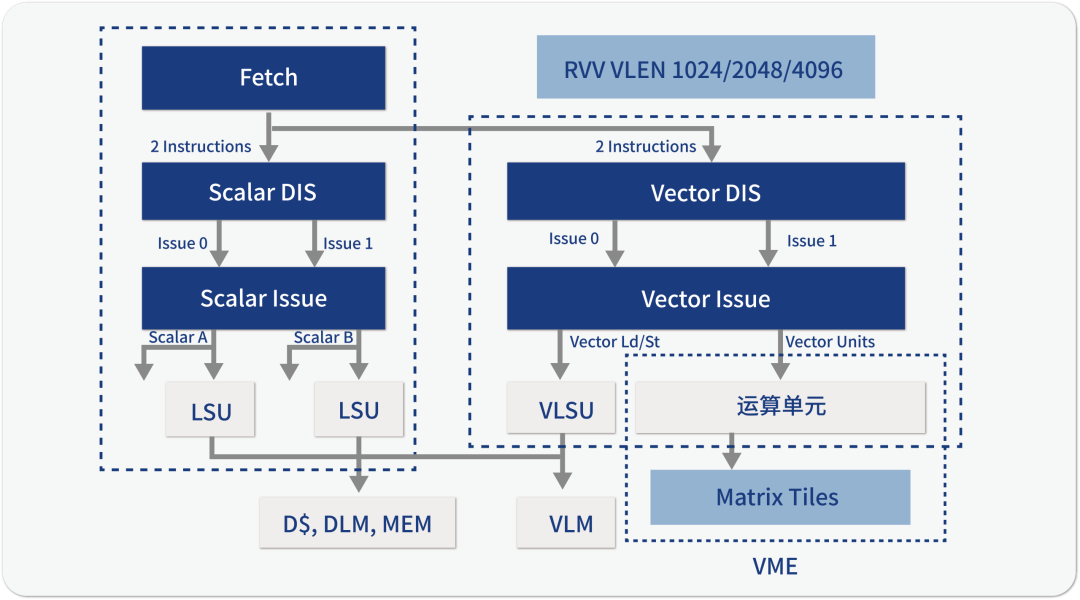
NI1000 支持 1024/2048/4096bit 原生 RVV 向量能力,硬件可配置 1024bit~4096bit 向量宽度,适配日益增大的通用算力需求。还支持 Vector-NICE 接口,允许用户自定义指令加速特定向量运算。
VME 矩阵扩展与 RVV 同核紧耦合
NI1000 支持 VME(Vector Marix Extension)矩阵扩展:VME 与 CPU/RVV 同核紧耦合,提供原生矩阵运算指令,提升矩阵算力,VME 与 RVV 共享寄存器组与运算单元仅增加少量 Matrix Tiles 面积资源。
成本与性能平衡适中,辅助 NPU:VME 融合 RISC-V 通用向量能力与专用矩阵累加能力,通用计算与 AI 矩阵计算兼顾。对比 IME 拥有独立矩阵累加硬件,矩阵运算能效更高;对比 AME 省去完整独立矩阵寄存器堆与硬件矩阵加速器,兼顾硬件开销可控与矩阵算力能效。非常适合作为辅助NPU的通用并行计算内核。
RV 软件生态兼容性好:VME(Vector Marix Extension)矩阵扩展完全基于 RISC-V Vector Extension 作为基座,软件生态基础好,VME 将成为最早标准化的 RISC-V Matrix Extension。
VME指令的源操作数复用RVV的寄存器组,且VME的运算单元开销可完全复用RVV运算单元。
VME 新增若干条原生矩阵运算指令,运算结果存储至专用的 Matrix Tiles 中。此外,VME 新增对于 FP8 数据类型的原生支持。
数据加载:复用 RVV 寄存器通过 load 指令从内存加载至 RVV 向量寄存器 Vr1 和 Vr2
累乘计算:VMMA 指令复用 RVV 计算单元对用向量寄存器 A、B 做外积乘法,把(Vr1×Vr2)个乘积累加进专用(N×N)矩阵累加Matrix Tiles。
存放结果:每一次外积结果可持续叠加到 Matrix Tiles。多个 Tiles 实现乒乓并行吞吐,提高并行性。
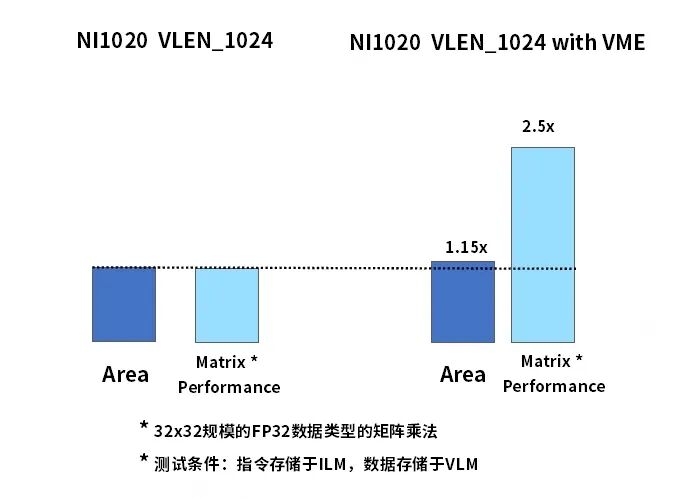
在 VME 矩阵扩展下执行 32×32 规模 FP32 数据类型的矩阵乘法,如上图所示,在整体面积仅增加 15 %的情况下(主要是 Matrix Tiles 带来的面积增加),矩阵乘法性能提升 2.5 倍。
NICE 可扩展指令接口助力系统协同
NI1000 提供 NICE/VNICE 用户可扩展指令接口。NICE(Nuclei Instruction Co-unit Extension)是芯来 CPU IP 的一种用户可扩展指令接口机制,用户可基于芯片标准通用 CPU 内核自主定义扩展指令集:
NI Core 提供用于 Scalar 指令扩展的 NICE 接口,可支持单周期,多周期,流水线等不同指令类型。NI Core 的 NICE 扩展单元不仅可以进行运算型的自定义指令扩展,还可以通过专用总线访问 Core 的存储资源(DCache等)实现与主 Core 的内存一致性
NI Core 提供 Vector 指令扩展的 NICE 接口, 可支持单周期,多周期,流水线等不同指令类型
用户可结合自己的应用扩展自定义指令,将 NI Core 内核扩展为面向 AI 领域进一步强化的专用处理器。
总结一:RISC-V 是适合 AI 芯片最好的 ISA
总结二:NI1000满足AI芯片对于算力核的核心诉求
AI 芯片算力核需要强大的矢量并行算力
NI1000 原生支持 RVV1.0 向量单元,VLEN 可配置 1024/2048/4096bits
NI1000 支持 FP16、BFP16、INT8 等多精度,高效承载 AI 算子
NI1000 可扩展支持 VME 向量矩阵扩展
AI 芯片算力核支持紧耦合自定义硬件加速
NI1000 可通过 NICE/VNICE 接口扩展自定义标量 / 矢量指令;支持与 NPU 加速器紧耦合集成,适配异构 AI 算力架构。
AI 芯片算力核需要成熟 RISC-V 软件生态
NI1000 支持的 RVV 在 AI 方面的软件生态呈蓬勃发展态势
NI1000 支持的 VME 复用 RVV 软件生态,节约开发时间配套 AI 软件栈
AI 芯片算力核需要高带宽访存、与片上加速器高效数据交互
NI1000 支持多级缓存架构:L1 I/D Cache + Cluster 共享缓存;
NI1000 支持 IOCP 缓存一致性端口,与片上 NPU / 加速器保持缓存一致性,降低数据搬移开销。
NI1000 支持 VLM 矢量 Local Memory Port 提供专用的高速吞吐通路。
综上所述
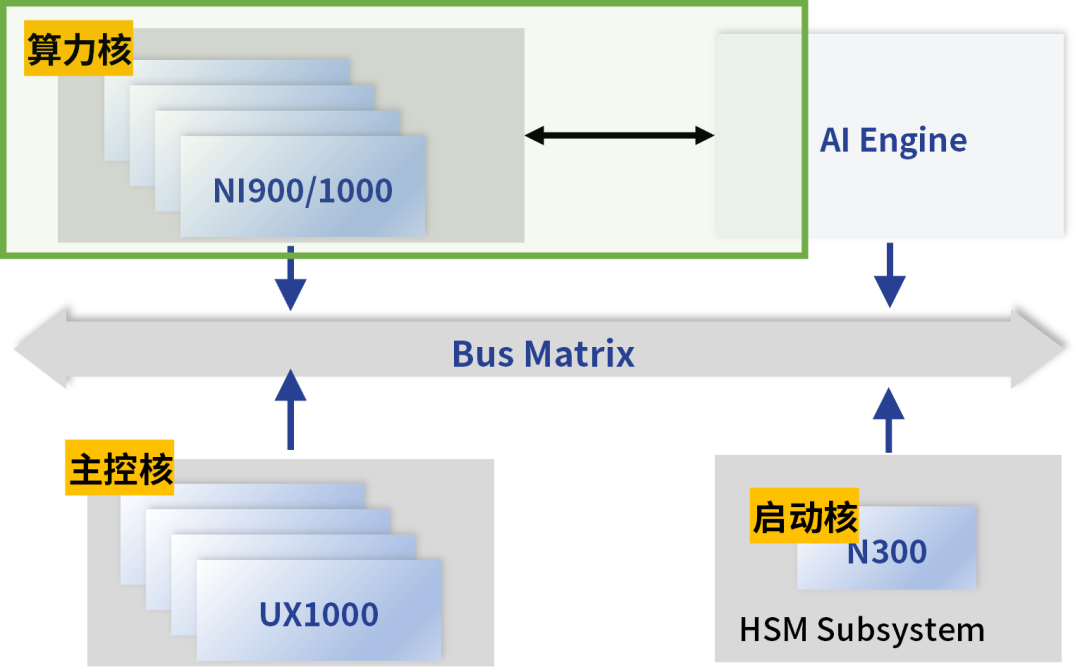
NI1000 高性能通用并行计算内核,以 RVV、VME 加速赋能 AI 芯片发展。在 RISC-V 开放生态下,NI1000 既可承担 AI 芯片中的通用 AI 算力核,也可与各种 NPU 等加速器紧耦合协同,形成更完善的整体解决方案。芯来科技将持续以开放 RISC-V 生态为底座,为 AI 芯片公司提供从主控核、算力核到子系统方案的全栈支持。